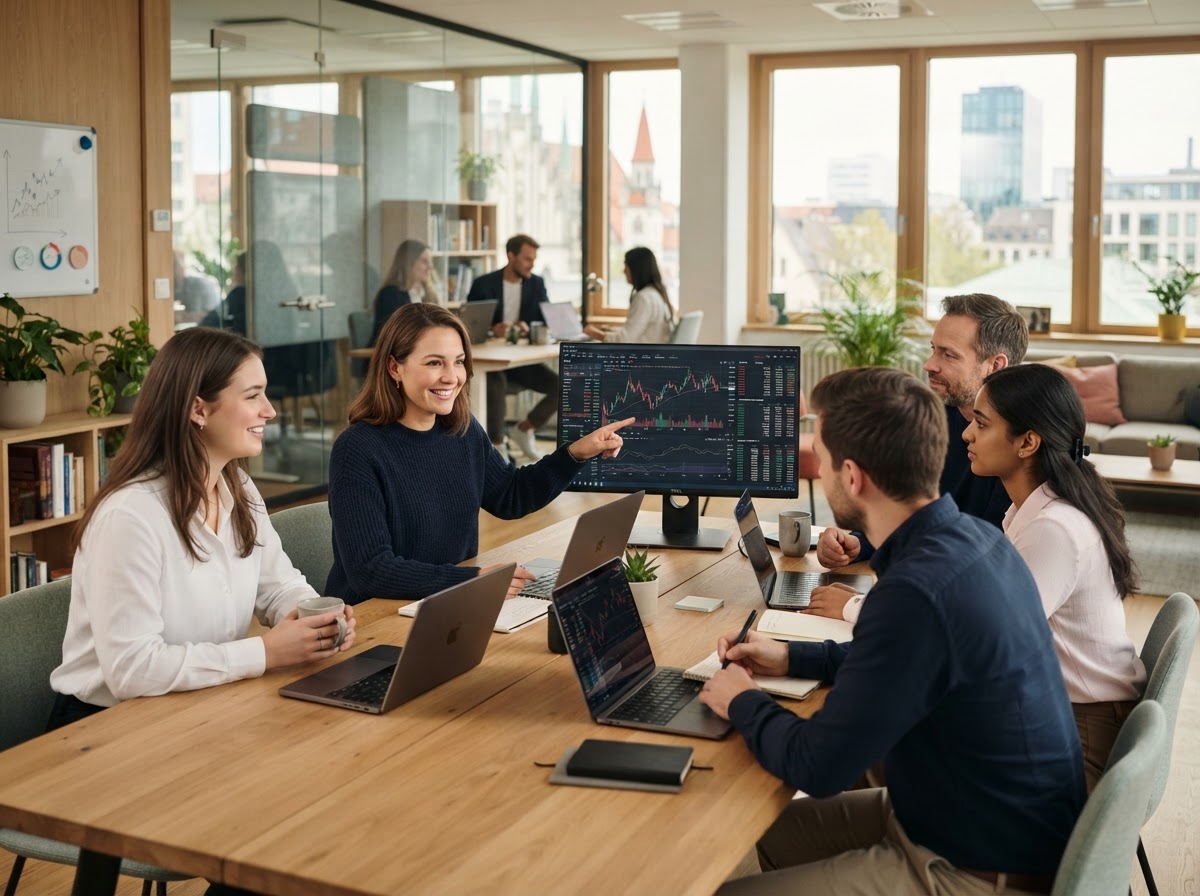
STOCK-XTRADER PRO-handelsdashboard met uniforme marktgegevensstromen voor meerdere beurzen

Beslissingen gebaseerd op data, niet op giswerk

STOCK-XTRADER PRO verzamelt orderboeken, prijsacties en volumegegevens van meerdere beurzen in één voorspellend model, en zet dat model vervolgens om in aanbevelingen waarop u binnen enkele seconden actie kunt ondernemen.

Live dashboardweergave: geconsolideerde orderstroomsignalen, blootstellingslimieten en een gerangschikte lijst met op maat gemaakte aanbevelingen, bijgewerkt bij elke markttik.
Uniforme intelligentie

Eén datastroom in plaats van twaalf open tabbladen

De meeste daghandelaren volgen posities op verschillende beurzen, elk met zijn eigen API-formaat, tarieflimieten en latentieprofiel. STOCK-XTRADER PRO neemt deze gefragmenteerde gegevens op, normaliseert deze op basis van een gedeeld schema en voert deze in een enkele voorspellende laag - dus het signaal dat u ziet, houdt al rekening met de verschillen tussen locaties.

  • —API-opname met lage latentie: marktgegevens worden continu verzameld in plaats van met vaste intervallen te worden opgevraagd, waardoor de kloof tussen een gebeurtenis en de verschijning ervan in uw dashboard wordt verkleind.
  • —Genormaliseerde datastructuren: prijs-, diepte- en volumevelden zijn vóór analyse gestandaardiseerd op alle beurzen, zodat vergelijkingen accuraat blijven.
  • —Enkele afstemmingslaag: dubbele of tegenstrijdige offertes op verschillende locaties worden gemarkeerd en niet stilzwijgend gemiddeld.
STOCK-XTRADER PRO-illustratie van gegevensintegratie waarin meerdere uitwisselingsfeeds worden samengevoegd in één dashboard
Kerncapaciteiten

Drie functies, één continue feedbacklus

Analyse identificeert wat er gebeurt, optimalisatie test wat zou kunnen werken, en risicobeperking beperkt wat er mis kan gaan. Elke functie leest uit dezelfde genormaliseerde datastroom die hierboven is beschreven.

01

Realtime patroonherkenning

Prijs- en orderstroompatronen worden vergeleken met historische precedenten op alle verbonden beurzen zodra ze zich vormen, en niet nadat de kaars is gesloten. Wedstrijden worden weergegeven met een betrouwbaarheidsscore, geen garantie.

02

Strategie back-testen met synthetische gegevens

Voordat een strategie in aanraking komt met levend kapitaal, wordt zij geconfronteerd met synthetische marktscenario's die zijn opgebouwd uit historische volatiliteit en liquiditeitsomstandigheden, waardoor zwakheden worden blootgelegd die alleen op basis van zuivere historische gegevens verborgen zouden kunnen blijven.

03

Geautomatiseerde hedgingaanbevelingen

Wanneer de blootstelling aan een bepaald activum of een bepaalde beurs een door u gedefinieerde drempel overschrijdt, stelt het platform compenserende posities voor en markeert het de limietoverschrijding – de transactie zelf wordt altijd door u uitgevoerd, niet door het systeem.

Methodologie

Wat gebeurt er tussen een gegevensvinkje en een aanbeveling

We beschrijven deze cyclus in detail omdat ‘vertrouw op het model’ geen afdoende antwoord is voor handelaren die echt kapitaal beheren.

STAP 1

Gegevensopname

Orderboek-, handels- en volumegegevens van elke verbonden beurs worden parallel opgehaald en bij aankomst van een tijdstempel voorzien, en vervolgens door de eerder beschreven normalisatielaag gevoerd.

STAP 2

Neurale netwerkfiltering

De genormaliseerde stroom wordt gescoord door modellen die zijn getraind op historische multi-uitwisselingsgegevens, waarbij wordt gefilterd op patronen met een statistisch precedent en waarbij ruis wordt weggegooid die niet aan een minimale betrouwbaarheidsdrempel voldoet.

STAP 3

Bruikbare output

Overlevende signalen worden omgezet in een gerangschikte aanbeveling – entry, exit of hedge – met de redenerings- en vertrouwensscore eraan toegevoegd, zodat de beslissing om te handelen aan u blijft.

Over de ‘black box’-zorg: elke aanbeveling wordt weergegeven naast de gegevenspunten en de betrouwbaarheidsscore die tot de aanbeveling hebben geleid. Ruwe marktgegevens en de op maat gemaakte aanbevelingen van het platform worden altijd gepresenteerd als twee afzonderlijke, duidelijk gelabelde resultaten.
Gebruiksscenario's

Gebouwd voor verschillende tijdshorizonten, dezelfde databasis

De onderliggende analyse-engine verandert niet tussen profielen; alleen de drempels, rapportagecadans en aanbevelingsformaat worden aangepast.

Institutionele beleggers

Blootstellingslimieten en hedgingregels worden één keer op bureauniveau geconfigureerd en consistent toegepast op alle activaklassen en beurzen, met een audittrail voor elke aanbeveling die aan een handelaar wordt getoond.

  • Gegevensverwerkingspraktijken worden gedocumenteerd ter ondersteuning van de interne nalevingsbeoordeling, inclusief BaFin-relevante verwachtingen inzake het bijhouden van gegevens voor EU-handelsdesks.
  • Back-testrapporten kunnen worden geëxporteerd voor beoordeling door het risicocomité voordat een strategie wordt goedgekeurd voor live gebruik.

Actieve daghandelaren

Patroonherkenning loopt continu tijdens de markturen, waardoor hoogfrequente beslissingsondersteuning ontstaat zonder dat u elk wisseltabblad afzonderlijk hoeft te monitoren.

  • Waarschuwingen worden gerangschikt op basis van de betrouwbaarheidsscore, en niet alleen op frequentie, om ruis tijdens vluchtige sessies te verminderen.
  • Blootstelling op positieniveau over alle verbonden beurzen is zichtbaar in één geconsolideerd overzicht.

Portefeuillebeheerders

Aanbevelingen voor een herbalancering op de langere termijn worden gegenereerd op basis van trend- en correlatieverschuivingen tussen beleggingen, en niet alleen op basis van prijsbewegingen op de korte termijn.

  • De risicobeperkingsoutput richt zich op blootstellingslimieten op portefeuilleniveau in plaats van op afzonderlijke handelsafdekkingen.
  • Rapportage-intervallen kunnen worden ingesteld op dagelijkse of wekelijkse cycli, passend bij een mandaat voor de langere termijn.
Veelgestelde vragen

Directe antwoorden op de vragen die handelaren eerst stellen

Hoe worden handels- en accountgegevens beschermd?

Gegevens die onderweg en in rust zijn, worden gecodeerd en STOCK-XTRADER PRO verwerkt persoonlijke en handelsgegevens onder de AVG-vereisten die van toepassing zijn op gebruikers in Duitsland en de bredere EU. Accountgegevens voor verbonden beurzen worden gescheiden van analytische gegevens opgeslagen en worden nooit gebruikt om namens u transacties te plaatsen zonder uitdrukkelijke toestemming binnen uw eigen beursaccountinstellingen.

Welke uitwisselingen en datafeeds kunnen worden geïntegreerd?

Het platform maakt verbinding met belangrijke uitwisselings-API's via een genormaliseerde opnamelaag, wat betekent dat nieuwe uitwisselingen kunnen worden toegevoegd zonder de manier waarop gegevens in uw dashboard worden weergegeven te veranderen. De integratiediepte (alleen-lezen marktgegevens versus gegevens op accountniveau) is afhankelijk van de machtigingen die u aan elke verbonden API-sleutel verleent.

Hoe nauwkeurig zijn de AI-modellen en hoe wordt vooringenomenheid aangepakt?

Modellen worden getraind op basis van historische multi-exchange-gegevens en vóór de implementatie geëvalueerd aan de hand van perioden die buiten de steekproef vallen, waarbij aan elke aanbeveling betrouwbaarheidsscores worden gekoppeld in plaats van een enkel goed/mislukt-signaal. Trainingsgegevens worden beoordeeld op oververtegenwoordiging van specifieke marktregimes of activaklassen om de scheeftrekking naar omstandigheden die zich mogelijk niet herhalen te beperken.

Sluit u aan bij de volgende generatie datagedreven investeerders

Vraag sandbox-toegang aan om verbinding te maken met een alleen-lezen uitwisselingsfeed en live aanbevelingen te bekijken voordat u geld investeert.

Er is geen creditcard vereist voor de eerste toegang tot de sandbox.